---
marp: true
theme: gaia
paginate: true
backgroundColor: #fff
header: "Dateiformate, Schnittstellen, Speichermedien & Distributionswege (223015b)"
footer: "Michael Czechowski – HdM Stuttgart – SoSe 2026"
title: Dateiformate, Schnittstellen, Speichermedien & Distributionswege
---
# Dateiformate, Schnittstellen, Speichermedien & Distributionswege
**223015b** · Modul "Technik 1" · 1. Semester
Digital- und Medienwirtschaft
Hochschule der Medien Stuttgart
[https://librete.ch/hdm/223015b/](https://librete.ch/hdm/223015b/)
---

---
# Kapitel 1
## Datenfundamentale + Vom Signal zum Byte
---
# Was steckt eigentlich in einer Datei?
---
---
# WTF!?
```
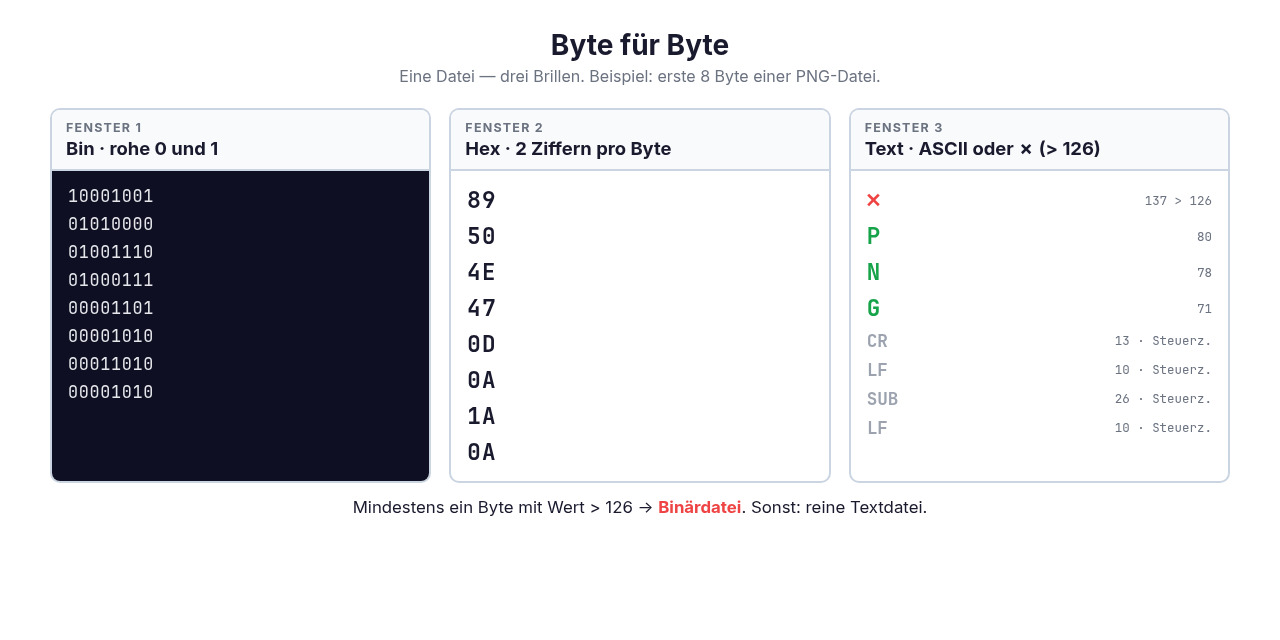
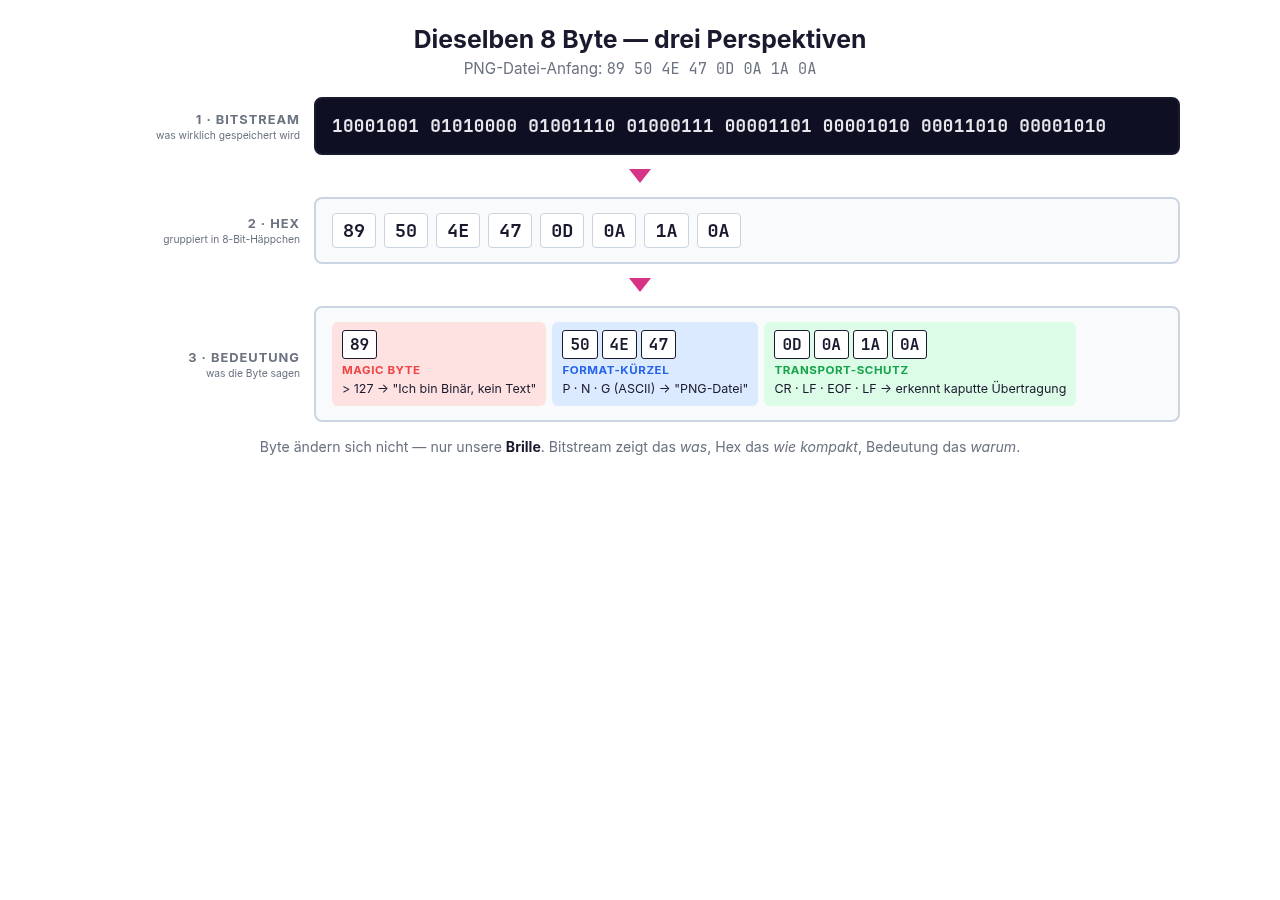
89 50 4E 47 0D 0A 1A 0A
00 00 00 0D 49 48 44 52
00 00 01 90 00 00 01 2C
```
---
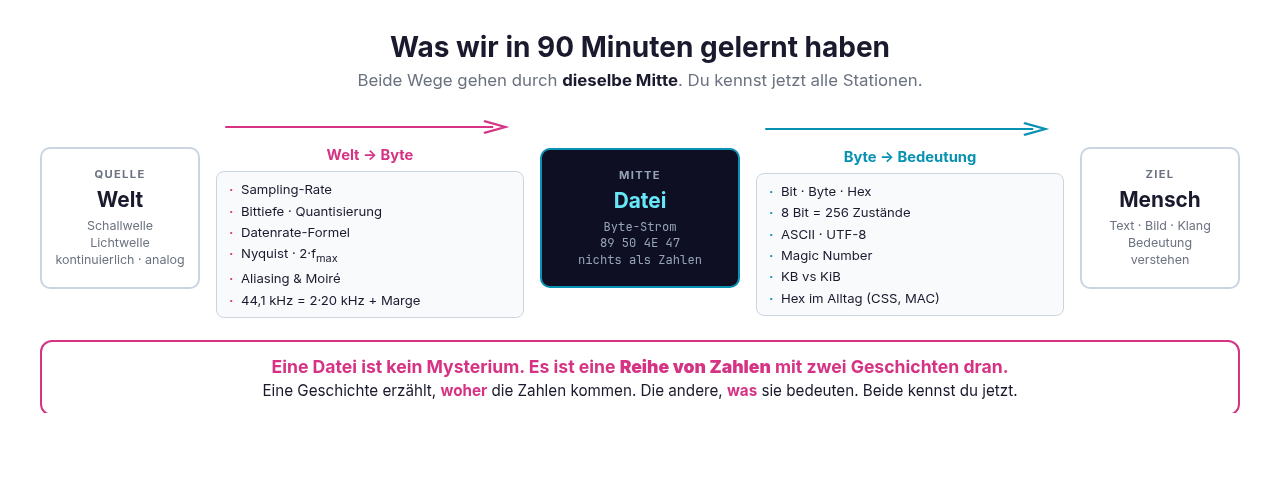
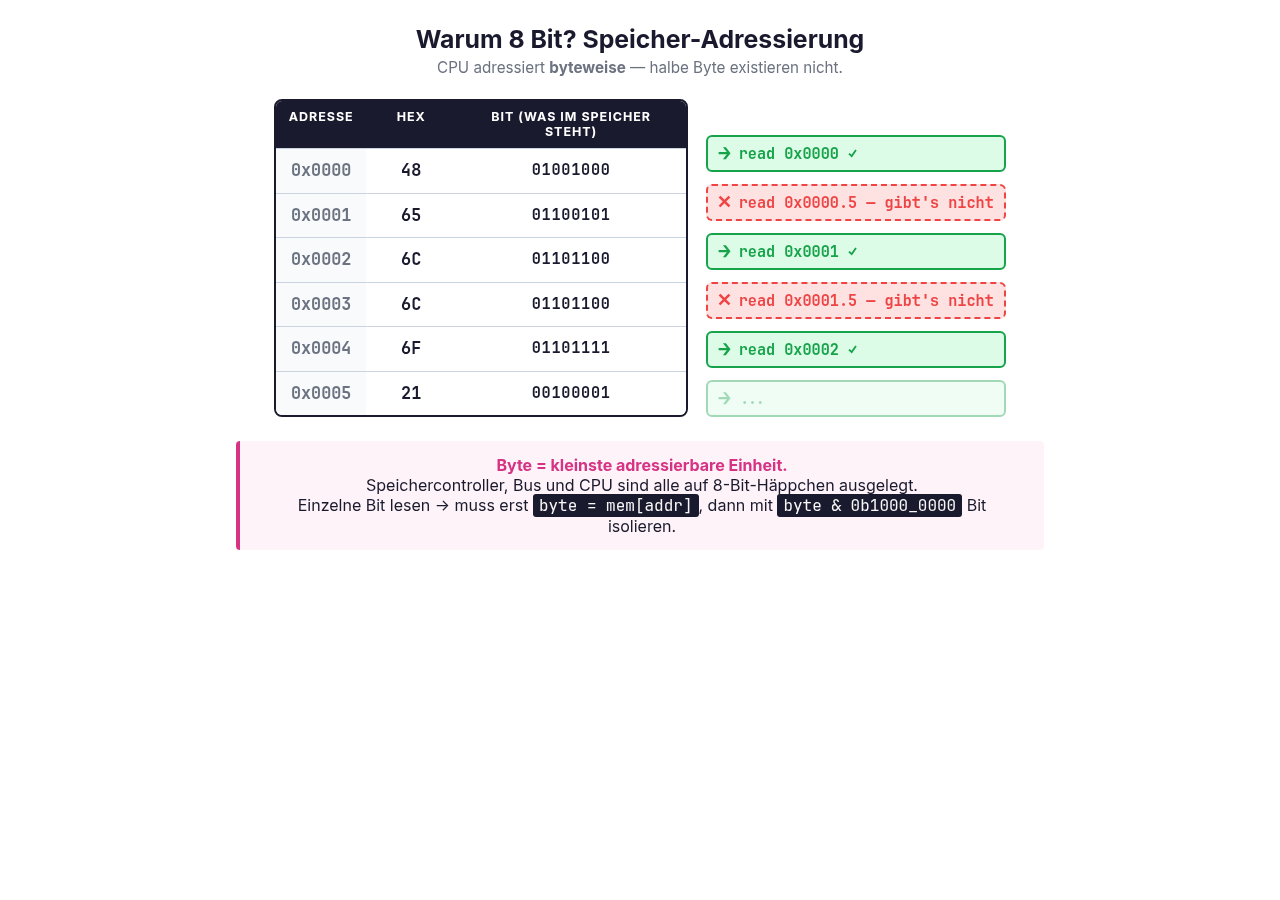
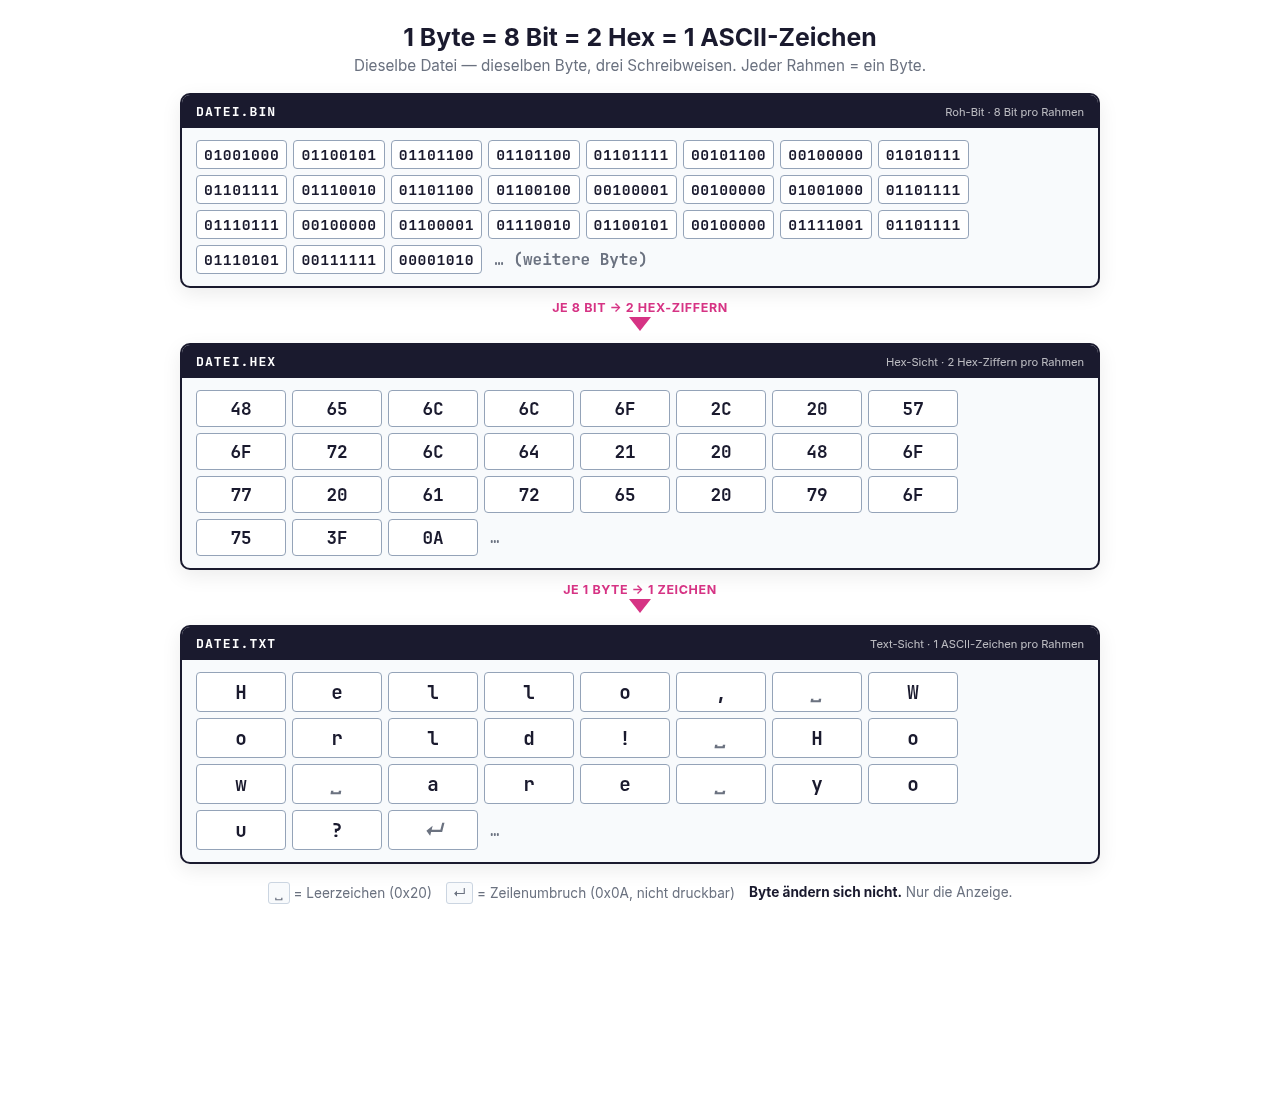
# Eine Datei ist ein Byte-Strom
**Vorne nach hinten. Ein Byte nach dem anderen.**
Egal welches Format — die Datei beginnt mit Byte 1 und endet irgendwann.
Jedes Byte ist eine Zahl zwischen `0` und `255`. *Mehr ist da nicht.*
---
---
---
---
---
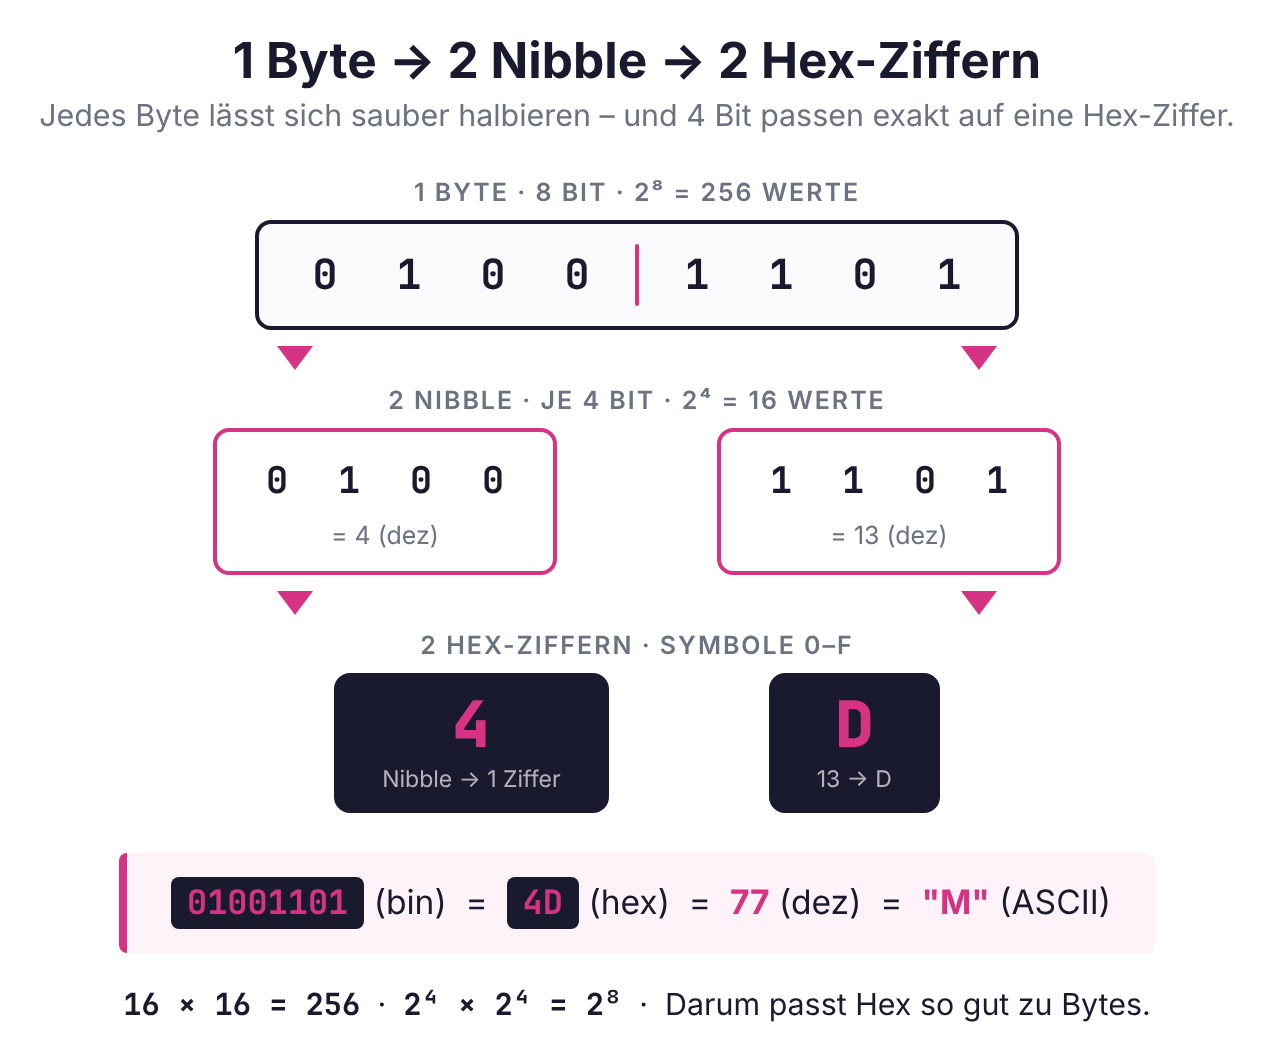
# 01010000 oder 50 — was liest sich leichter?
**Binär:** `01010000 01001110 01000111`
**Hex:** `50 4E 47`
Drei Byte. Dasselbe Inhalt. Hex ist nur **handlicher**.
**Wo trifft man Hex im Alltag?** Beim CSS-Farbcode:
`#FF5733` — das sind 3 Byte (Rot, Grün, Blau).
---
# Hex begegnet euch überall
| Kontext | Beispiel |
|---------|----------|
| CSS-Farben | `#FF5733` |
| MAC-Adressen | `00:1A:2B:3C:4D:5E` |
| Speicheradressen | `0xA04F20` |
| Windows-Fehlercodes | `0x80070005` |
| Unicode-Codepoints | `U+00E4` (ä) |
| Datei-Signaturen | `89 50 4E 47` (PNG) |
---
---
---
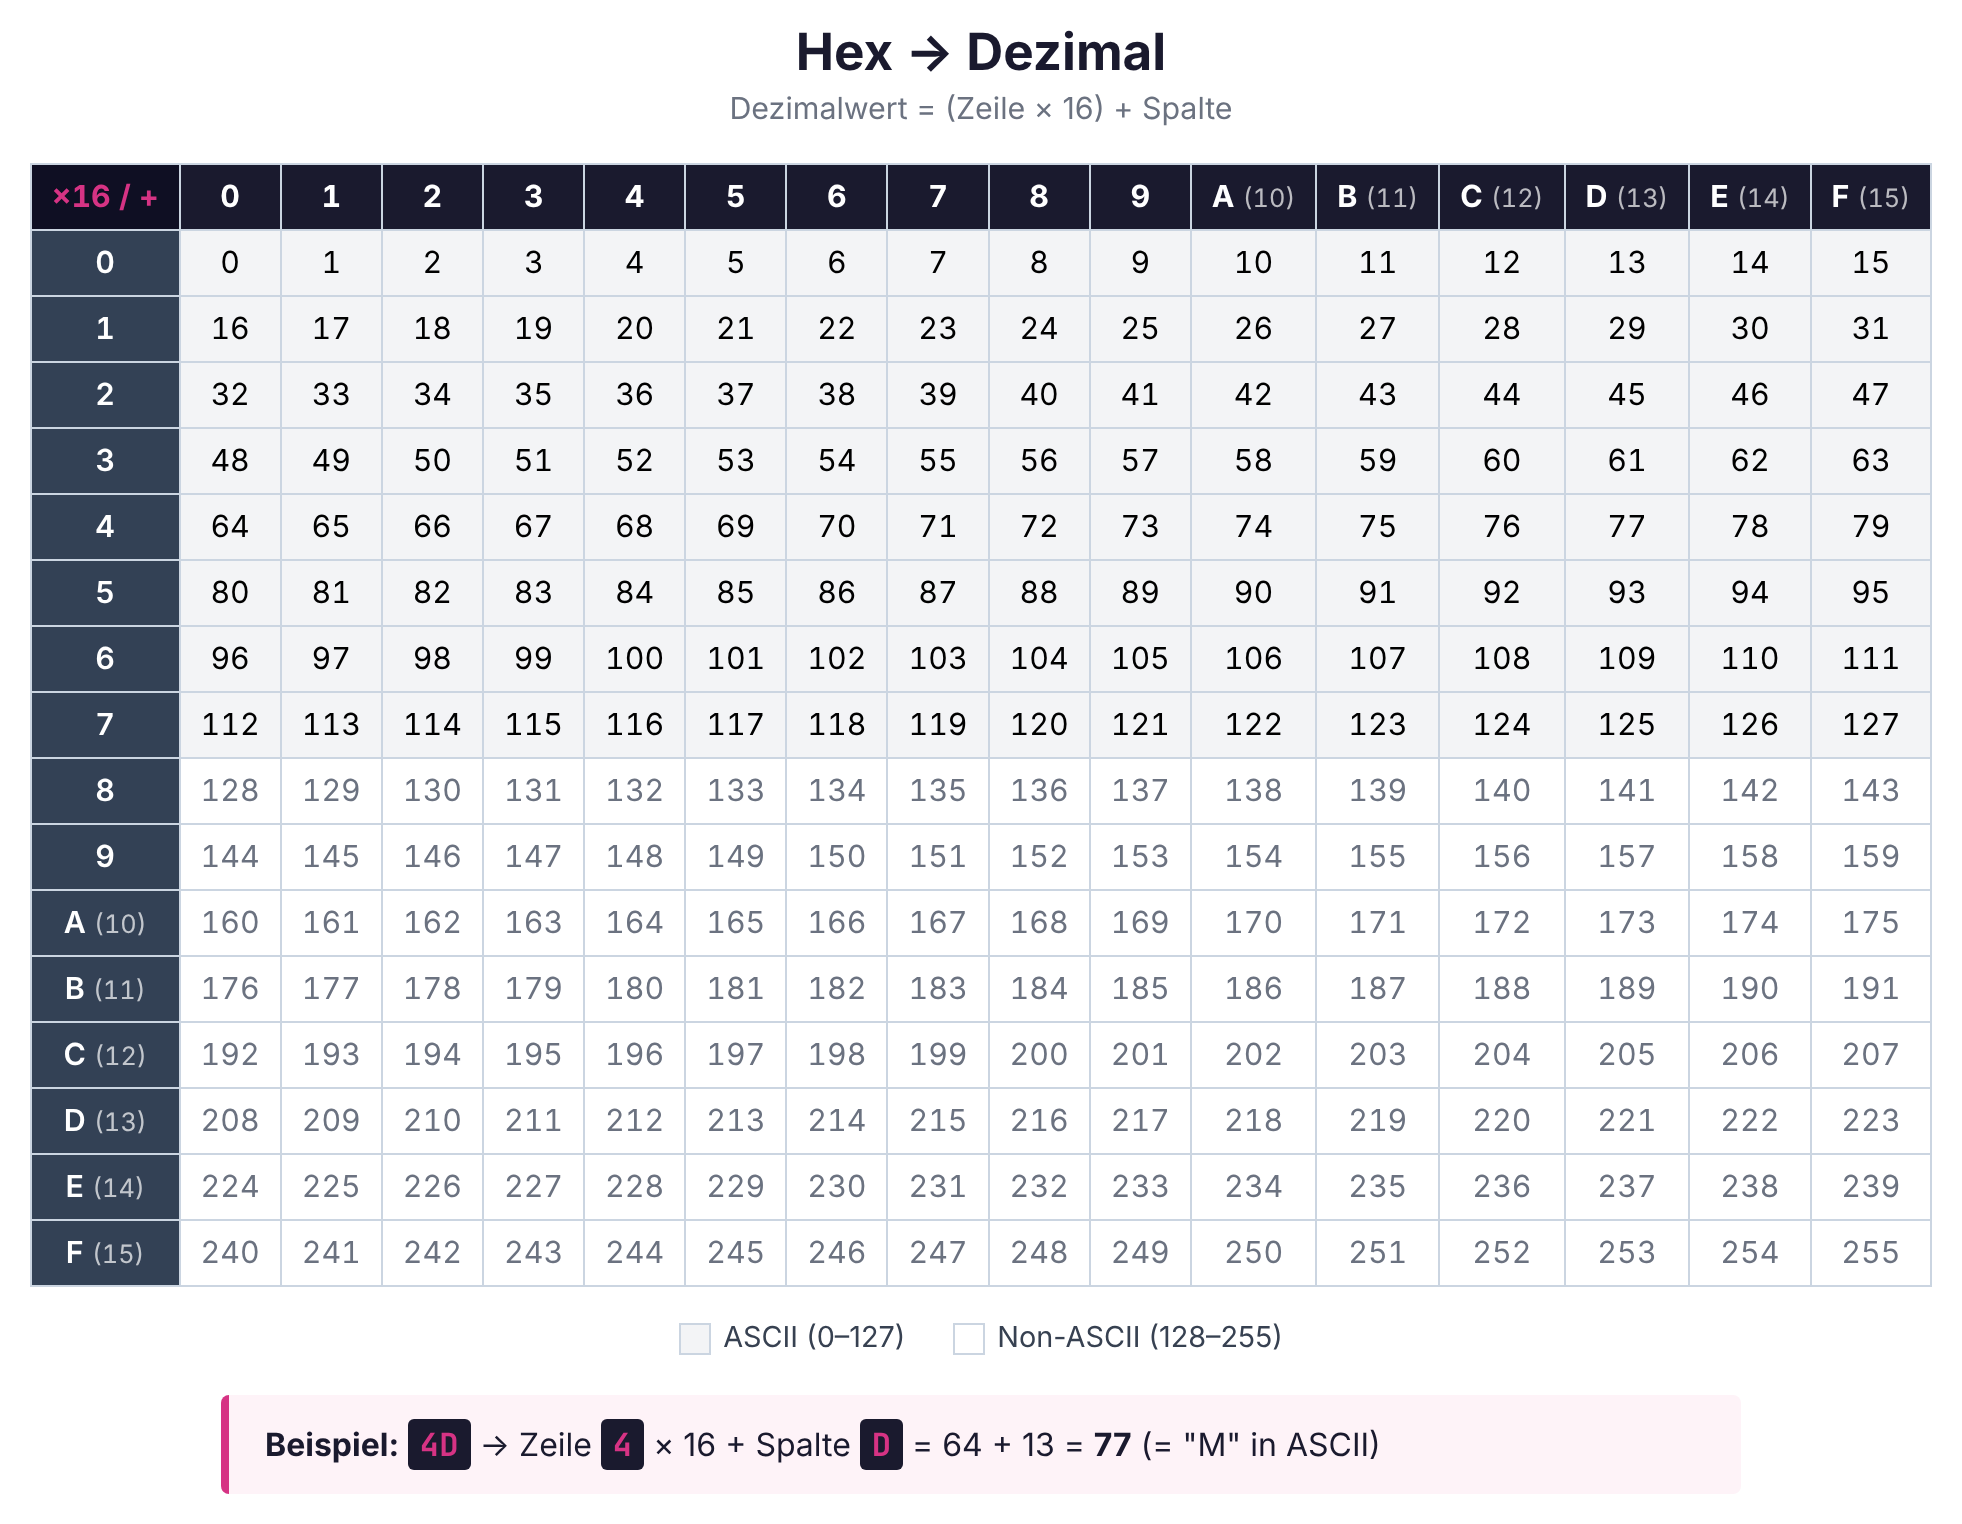
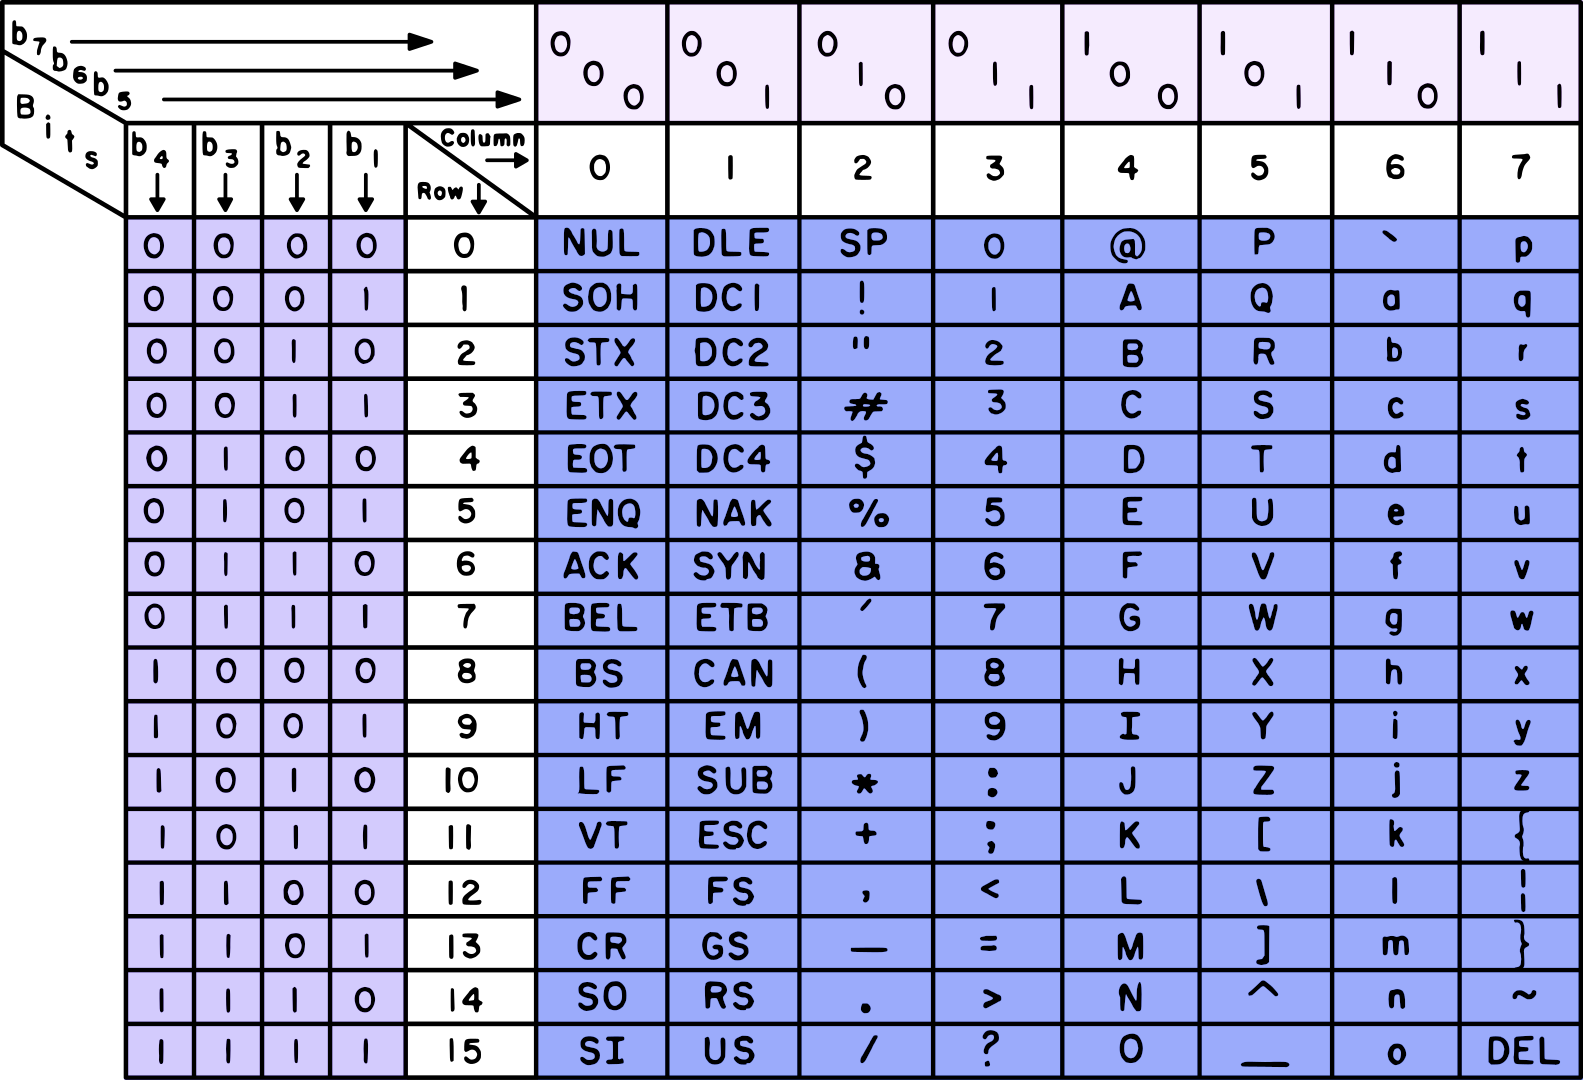
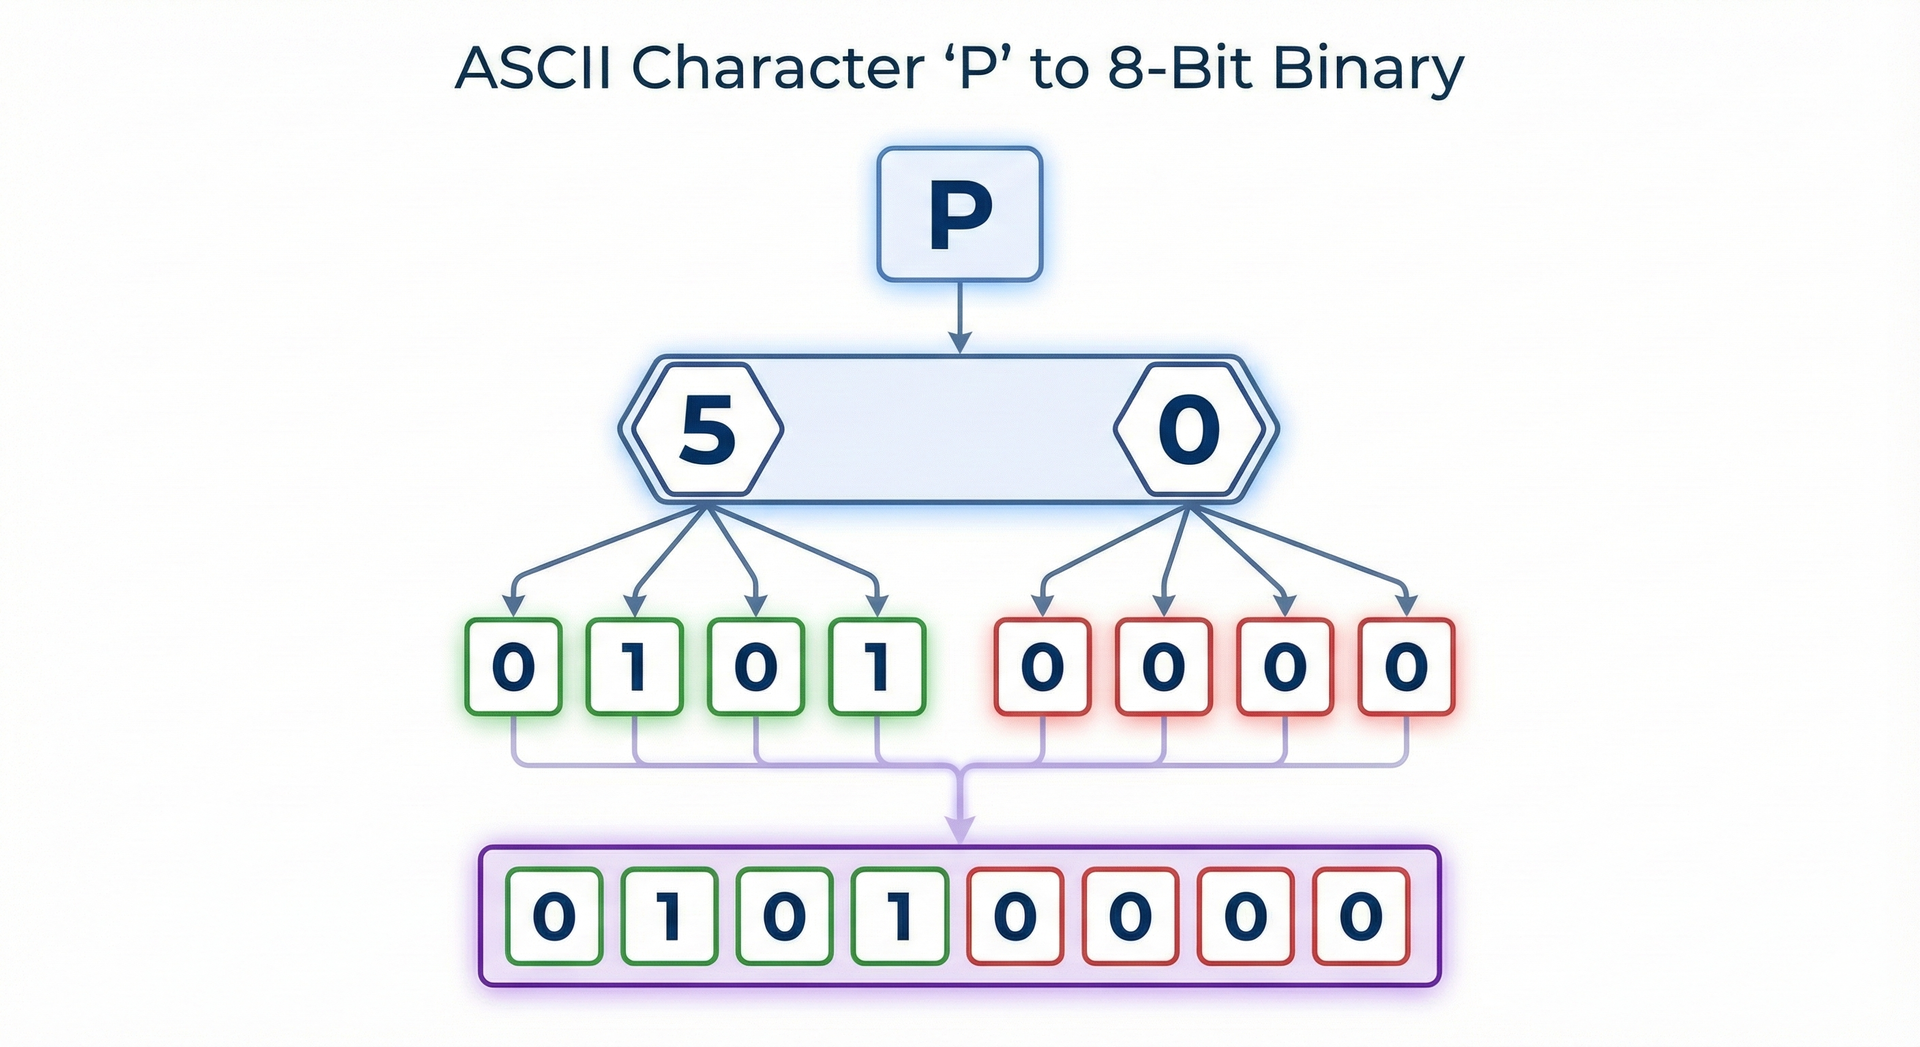
# Was bedeutet die Zahl `80`?
---
---
# ASCII reicht für Englisch.
## Aber was ist mit *ä, é, 中, 🌸*?
---
# Unicode: ein Standard für alle
**Unicode (1991):** jedes Schriftsystem der Welt.
**> 150.000 Zeichen.** Latein, Kyrillisch, Arabisch, Chinesisch, Japanisch, mathematische Symbole, Emoji.
**UTF-8** speichert Unicode mit *variabler Länge:*
- Zeichen 0–127: **1 Byte** (identisch mit ASCII — Abwärtskompatibilität!)
- Westeuropäische Umlaute: **2 Byte**
- Chinesisch/Japanisch: **3 Byte**
- Emoji: **4 Byte**
---
# Beispiel: Byte zählen
**Text:** `"Hello·🌸·こんにちは·(Kon-ni-chi-wa)"`
| Zeichen | Byte |
|---------|-------|
| `Hello·` | 6 × 1 = **6 Byte** (ASCII) |
| `🌸` | **4 Byte** (Emoji) |
| `·` | **1 Byte** |
| `こんにちは` | 5 × 3 = **15 Byte** (Hiragana) |
| `·(Kon-ni-chi-wa)` | **16 Byte** (ASCII) |
**Gesamt: 42 Byte für 29 sichtbare Zeichen.**
---
# Woher weiß der Computer, was das ist?
---
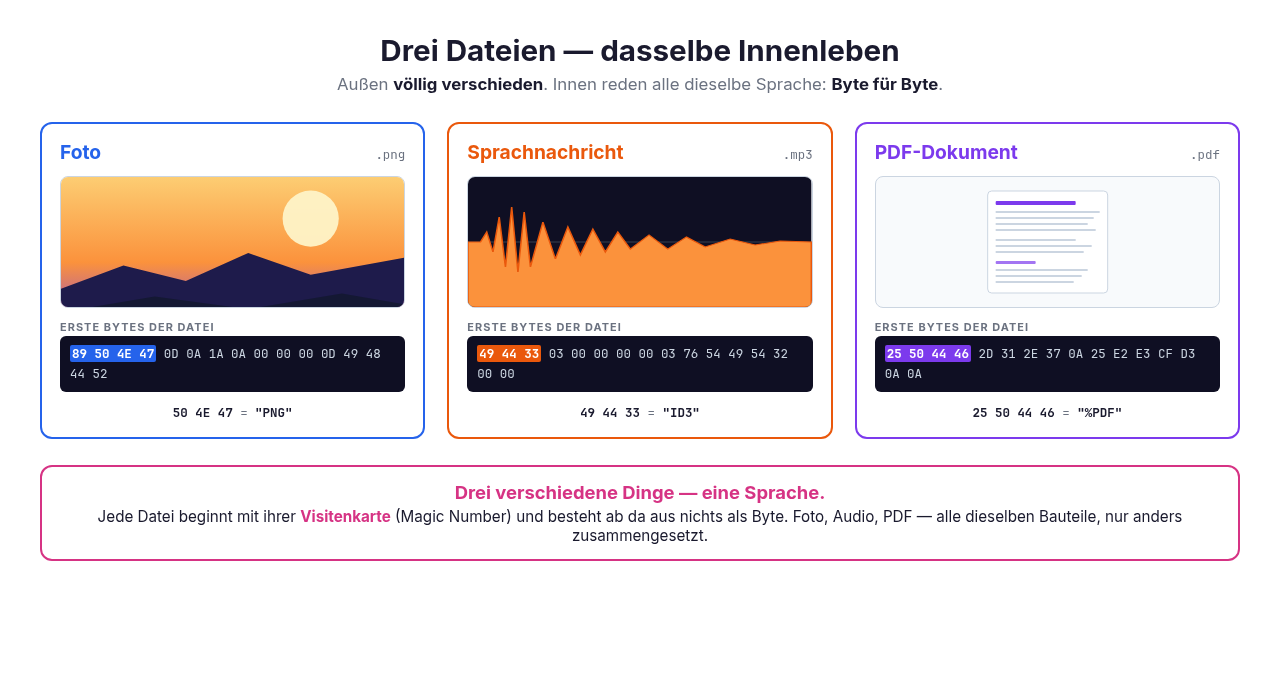
# Magic Numbers — die Visitenkarte der Datei
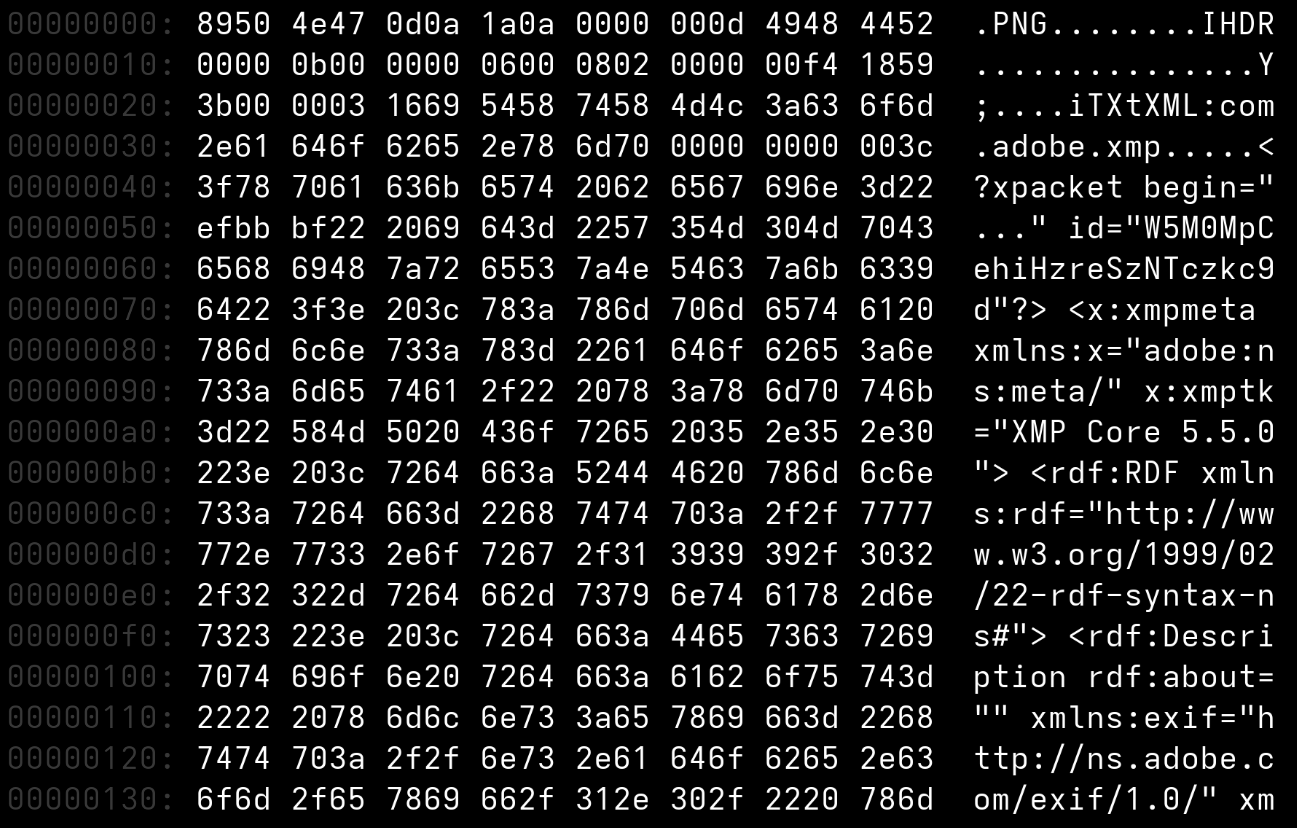
**Datei-Typ erkennt man an den ersten Byte:**
| Format | Magic Number (Hex) | Lesbar? |
|--------|-------------------|---------|
| PNG | `89 50 4E 47` | (89 außerhalb ASCII) P N G |
| JPEG | `FF D8 FF` | — |
| PDF | `25 50 44 46` | % P D F |
| ZIP | `50 4B 03 04` | P K — — |
**Achtung:** Werte > 127 sind nicht ASCII-druckbar. *Hex-Editoren zeigen `.` als Platzhalter.*
---
---
---
# Selbstlernen — HEX Files identifizieren
1. Fünf Dateien ohne Dateiendung:
`hex1` · `hex2` · `hex3` · `hex4` · `hex5`
2. Lies erste 16 Byte aus und identifiziere Dateiformat (Magic Number)
3. *Optional: Datei umbenennen und korrekte Dateiendung anhängen (z.B. `.jpg`)*
**Tools:** [hexed.it](https://hexed.it) · [Wikipedia-Magic-Number-Liste](https://en.wikipedia.org/wiki/List_of_file_signatures)
---
# KB vs KiB — warum „1 TB" als 931 GB angezeigt wird
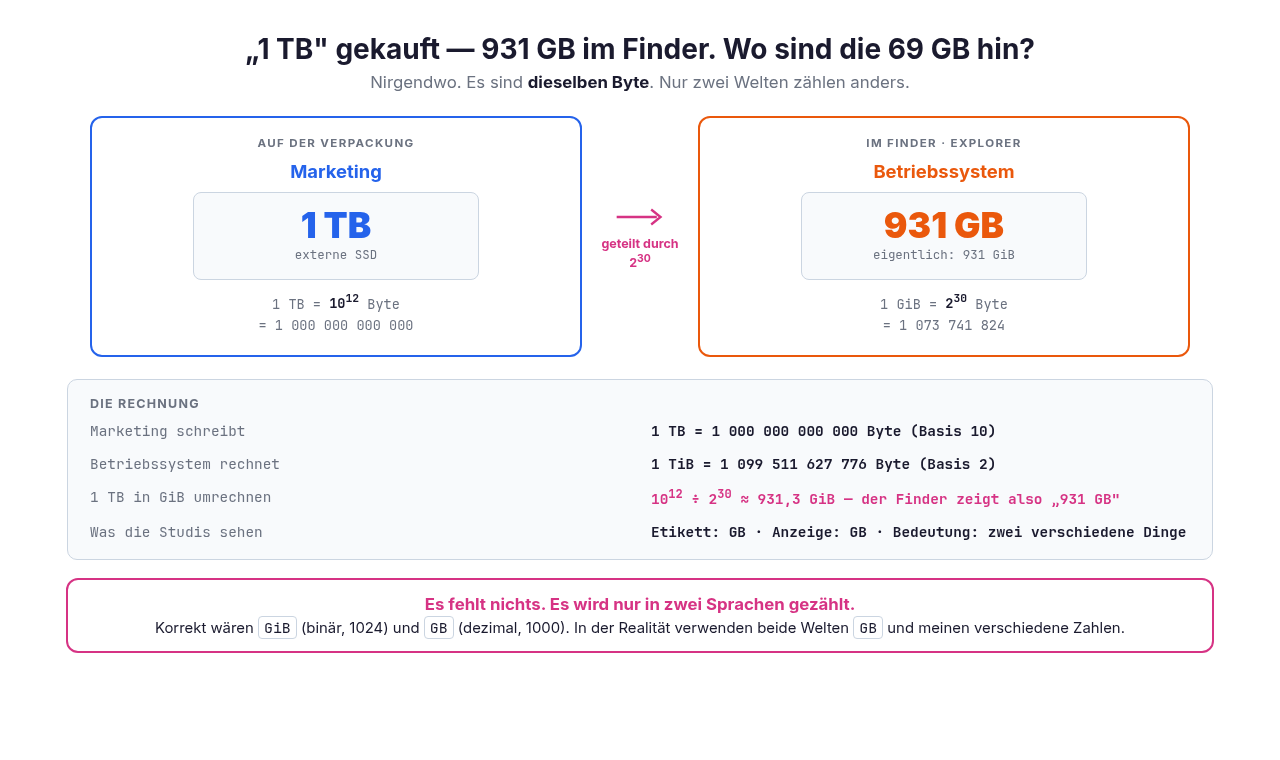
**Auf der Verpackung:** 1 TB = 10¹² Byte (dezimal).
**Im Finder:** 931 GB = eigentlich 931 GiB (binär, 1024³).
Es fehlt nichts — beide Seiten zählen nur in **verschiedenen Sprachen.**
---
# Dateneinheiten — Größenordnungen
| Einheit | Bytes (dezimal) | Beispiel |
|---------|------:|----------|
| **Byte** | 1 | Farbwert eines Pixels |
| **Kilobyte (KB)** | 1.000 | kleiner Programmcode |
| **Megabyte (MB)** | 1 Million | Textdokument |
| **Gigabyte (GB)** | 1 Milliarde | Kinofilm in FullHD |
| **Terabyte (TB)** | 1 Billion | ~12h Video in 4K |
| **Petabyte (PB)** | 1 Billiarde | Netflix-Gesamtarchiv |
| **Exabyte (EB)** | 1 Trillion | Alle E-Mails weltweit/Tag |
| **Zettabyte (ZB)** | 1 Trilliarde | globale Datenmenge ~heute |
---
---
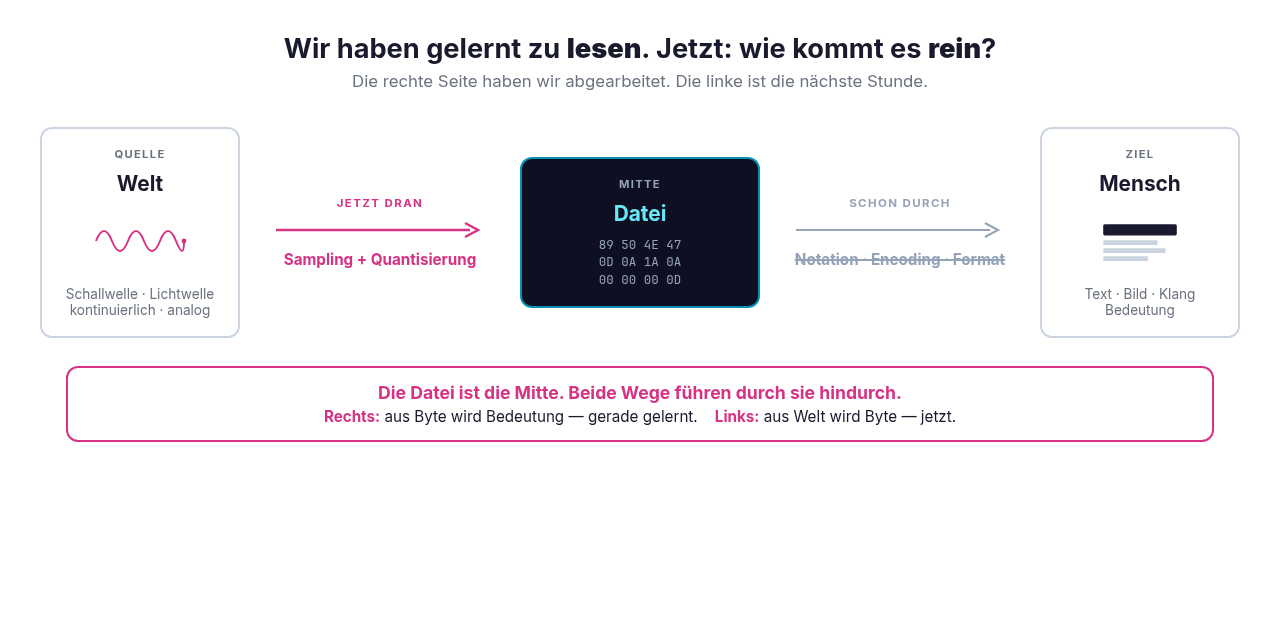
# Analog vs. Digital — am Beispiel Schall
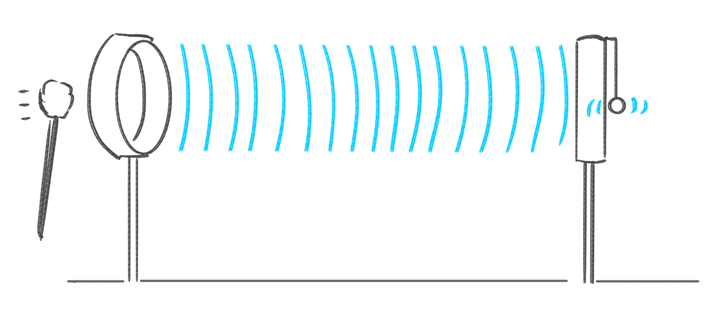
Eine Stimme ist eine **Druckwelle**. Kontinuierlich — keine Stufen, keine Sprünge.
Eine Audiodatei ist eine Folge von **Zahlen** — diskret, in Stufen.
Wie übersetzen wir die Welle in Zahlen?
**Zwei Schritte:** Sampling (wie oft) + Quantisierung (wie genau).
---
# Sampling — wie oft messen wir?
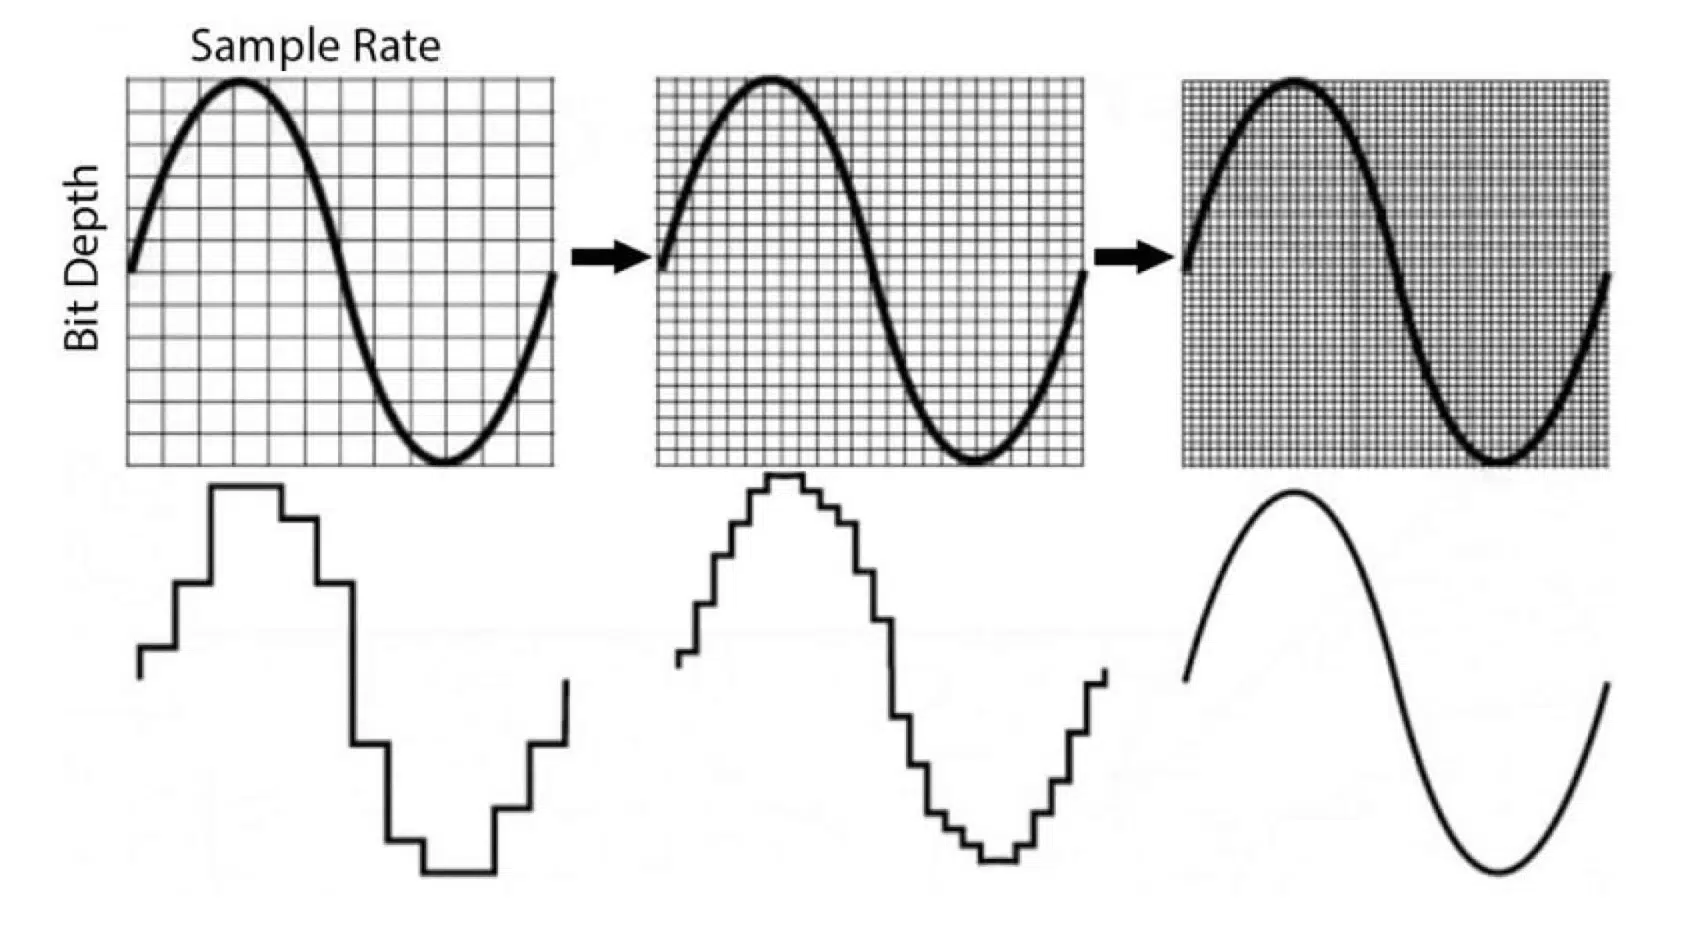
**Abtastrate** (Sample Rate) = wie viele Messungen pro Sekunde.
| Sample Rate | Anwendung |
|-------------|-----------|
| 8 kHz | Telefon |
| 22 kHz | alte Spiele-Sounds |
| **44,1 kHz** | **CD-Qualität** |
| 48 kHz | Video-Standard |
| 96 kHz | Studio |
Je höher die Sample Rate, desto näher kommt die Datei an die kontinuierliche Welle.
---
---
# Quantisierung — wie genau messen wir?
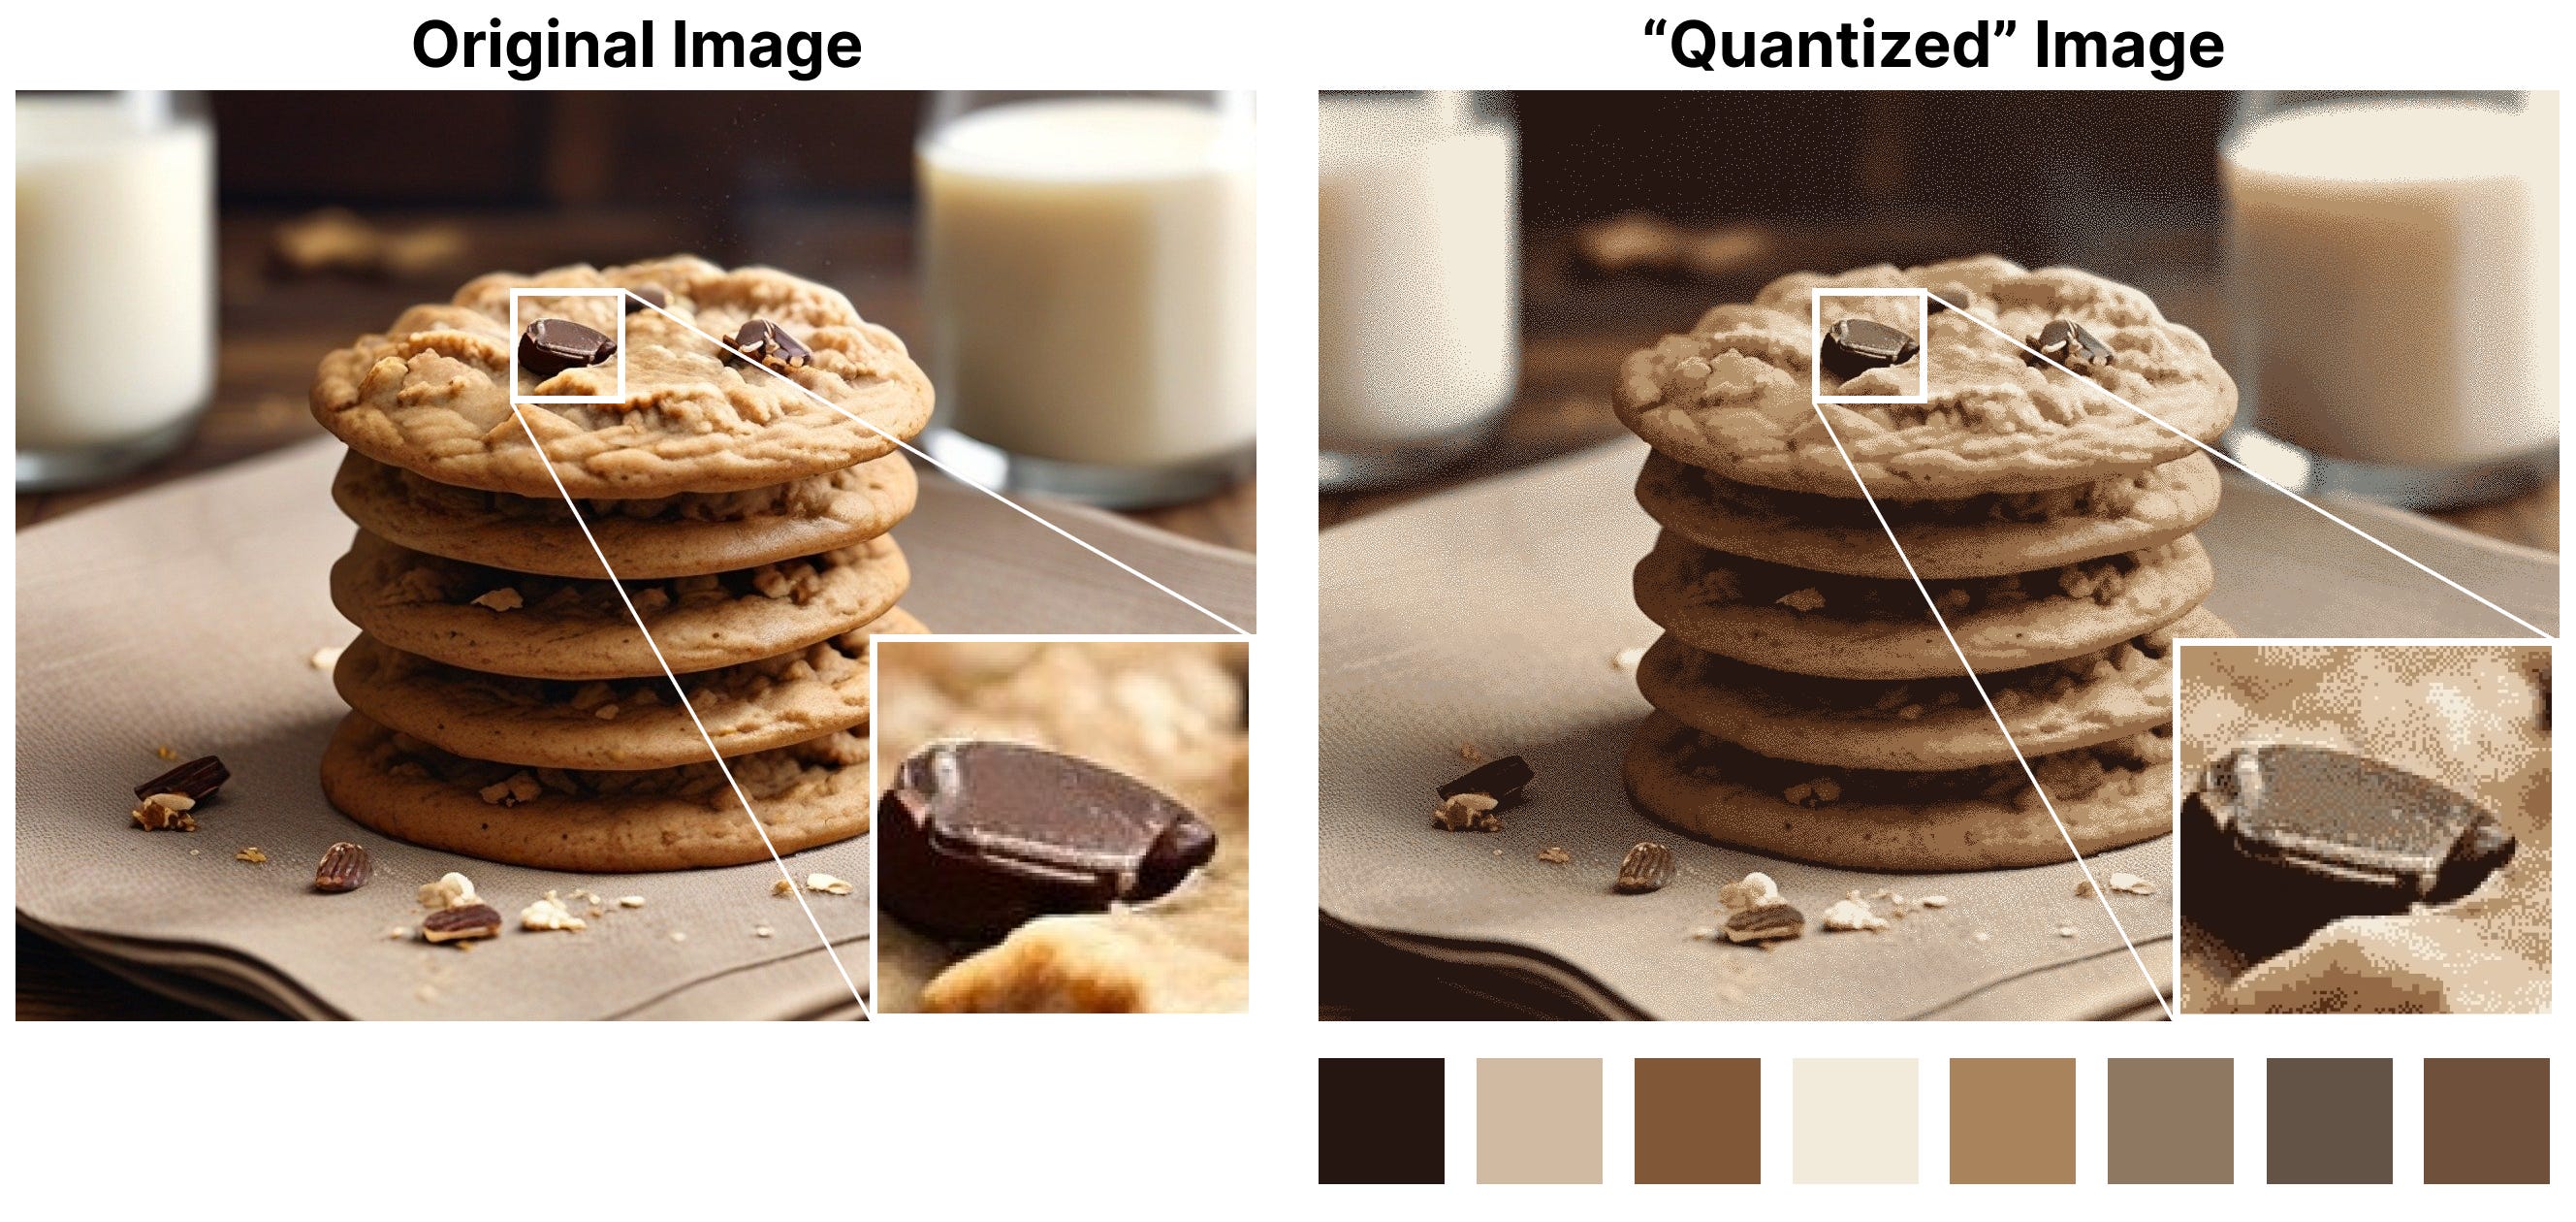
**Bittiefe** (Bit Depth) = wie fein wir jede Messung auflösen.
| Bittiefe | Stufen | Dynamikumfang |
|----------|--------|---------------|
| 8 Bit | 256 | ~48 dB |
| **16 Bit (CD)** | **65.536** | **~96 dB** |
| 24 Bit (Studio) | 16,8 Mio. | ~144 dB |
Je mehr Bit, desto kleiner der **Quantisierungsfehler** (Differenz zur Original-Druckwelle).
---
---
# Datenrate = Sample Rate × Bittiefe × Kanäle
**Formel:**
```
Datenrate (bit/s) = Sample Rate (Hz) × Bittiefe (bit) × Kanäle
```
**Was bestimmt jeder Faktor?**
- **Sample Rate:** Bandbreite (Höhe der erfassbaren Töne)
- **Bittiefe:** Dynamik (Stufenfeinheit)
- **Kanäle:** Stereo, Mono, Surround
Daraus ergibt sich, wie groß eine Audiodatei pro Sekunde wird — *unkomprimiert*.
---
# CD-Audio: die Rechnung
**Audio-CD (Philips/Sony 1982):**
```
44.100 Hz × 16 bit × 2 Kanäle = 1.411.200 bit/s = 1,4 Mbit/s
```
Pro Sekunde: ~172 KB. Pro Minute: ~10,3 MB. Pro Album (60 Min): ~635 MB.
*Eine ganze 90er-Festplatte für ein Album.*
---
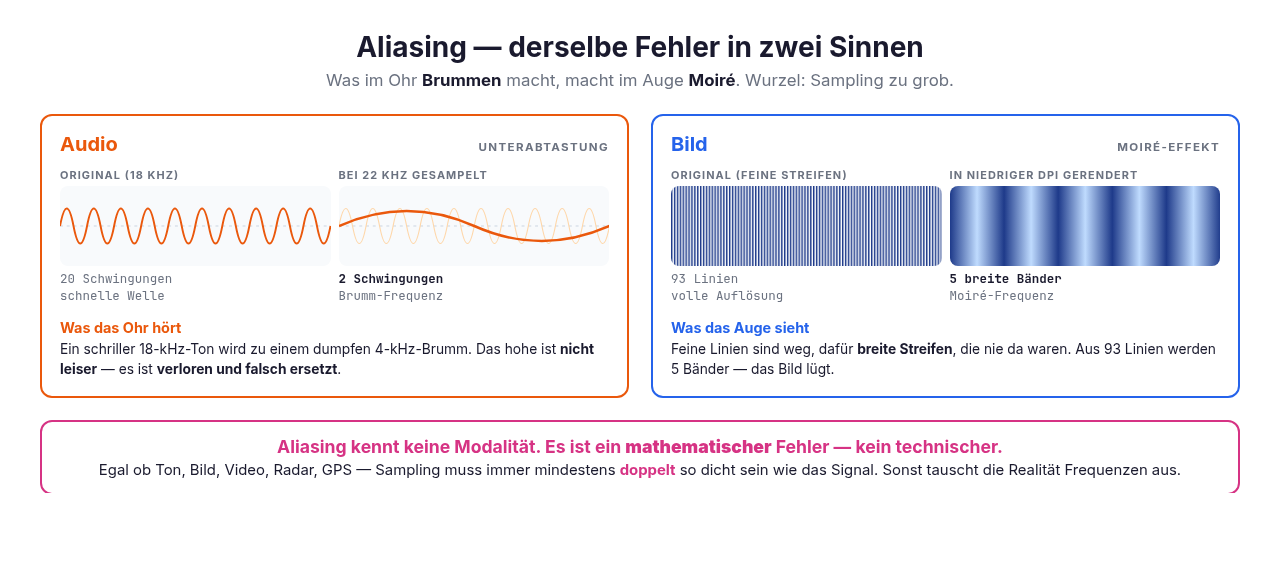
# Nyquist-Theorem — warum 2× reicht
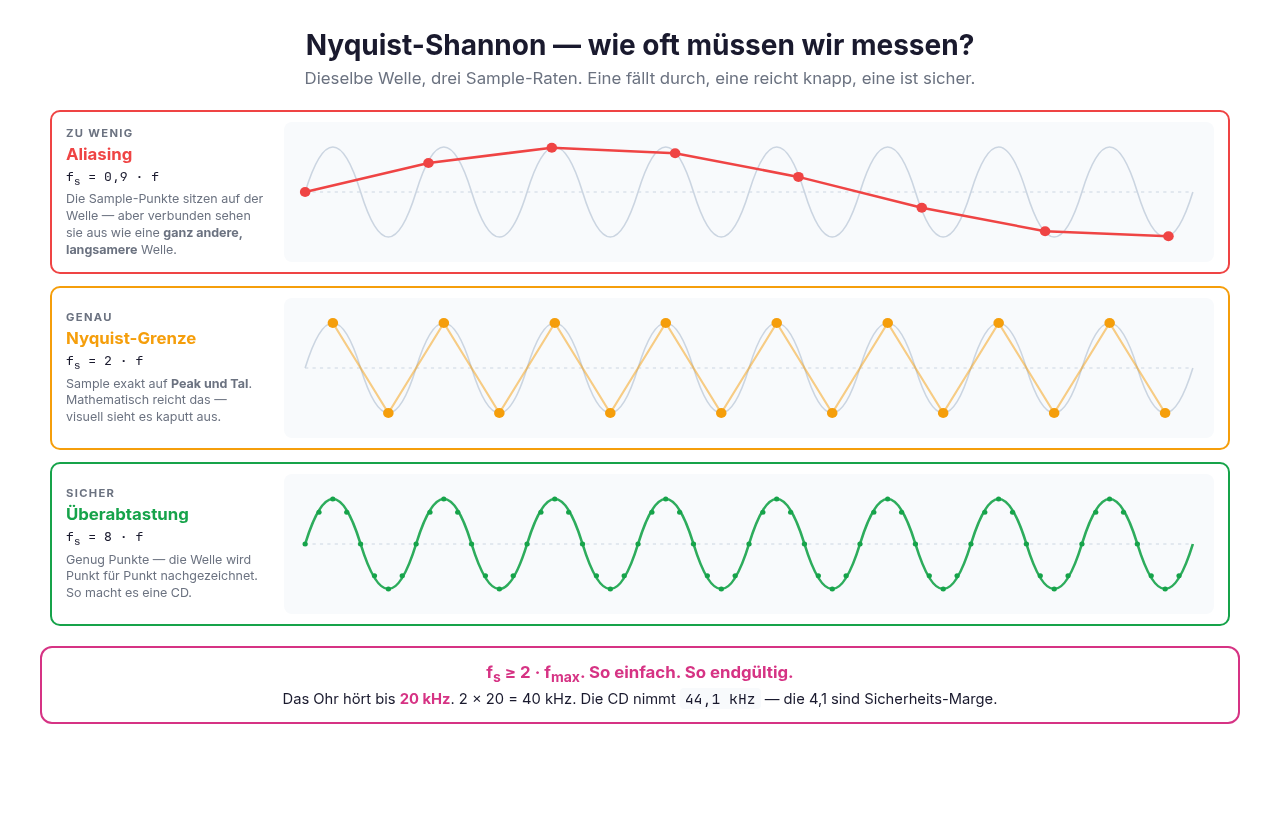
**Sample-Rate muss mindestens das *Doppelte* der höchsten Signal-Frequenz sein:**
```
f_sample ≥ 2 · f_max
```
Drei Fälle:
- **zu wenig** → Aliasing (falsche tiefere Welle)
- **genau** → mathematisches Minimum
- **mehr** → sichere Rekonstruktion
---
# Warum gerade 44,1 kHz?
**Menschliches Ohr hört bis ca. 20 kHz.**
2 × 20 kHz = 40 kHz minimum für Nyquist.
**Plus 4,1 kHz Sicherheitsmarge** (Tiefpassfilter sind nicht perfekt).
**Plus historische PAL/NTSC-Kompatibilität:**
44.100 Hz war exakt durch PAL- und NTSC-Video-Frame-Raten teilbar → CD-Master ließen sich auf den Video-Recordern jener Zeit produzieren.
---
---
# Selbstlernen — Spotify-Bitrate vergleichen
Auf eurem Handy:
1. Spotify öffnen, *Lieblings-Track laden*
2. Audio-Qualität-Einstellung wechseln zwischen **niedrig (24 kbit/s)** und **sehr hoch (320 kbit/s)**
3. Mit Kopfhörer auf **Höhen** achten (Becken, Zischlaute, „s"-Töne in Stimme)
**Was fällt auf?** Welche Frequenzen verschwinden zuerst?
---
# Selbstlernen — Audacity Sample-Rate-Vergleich
1. **Audacity** installieren (kostenlos, audacityteam.org)
2. Eigene Stimme aufnehmen (5 s, irgendwas reinsprechen)
3. Datei → Exportieren als WAV bei **8 kHz**, **22 kHz**, **44,1 kHz**
4. Vergleichen: Größe der Datei + Klangqualität
**Beobachtung:** Größe wächst linear mit Sample Rate. Qualität auch.
---